한입AI사전 › 컨텍스트 윈도우
컨텍스트 윈도우란? AI가 한 번에 읽을 수 있는 양
context window · 컨텍스트 길이 · 문맥 창 · 토큰 한도
컨텍스트 윈도우는 AI 언어 모델에 한 번에 넣을 수 있는 토큰 수의 상한입니다. AI는 대화를 기억하지 않고 매번 지금까지의 대화 전체를 다시 읽기 때문에, 대화 · 지시문 · 올린 파일이 모두 이 안에 들어가야 합니다.
AI는 대화를 기억하지 않는다
AI와 대화하면 앞에서 한 말을 기억하는 것처럼 보입니다. 실제로는 다릅니다. 새 메시지를 보낼 때마다 AI에게 넘어가는 것은 지금까지의 대화 전체 목록입니다.
- 맨 위에 서비스나 도구가 붙여 둔 지시문
- 그 아래로 나와 AI가 주고받은 대화
- AI가 읽은 파일 내용과 찾아본 자료
이 목록 전체가 매번 다시 들어갑니다. AI가 앞 내용을 기억하는 것처럼 보이는 이유는 매번 처음부터 다시 읽기 때문입니다.
한 번에 넣을 수 있는 양의 상한
AI는 글을 토큰 단위로 읽고, 한 번에 넣을 수 있는 토큰 수에는 상한이 있습니다. 이 상한이 컨텍스트 윈도우입니다. 몇 년 전에는 4,000토큰 정도였지만 지금은 100만 토큰까지 늘었습니다. 책 여러 권 분량입니다.
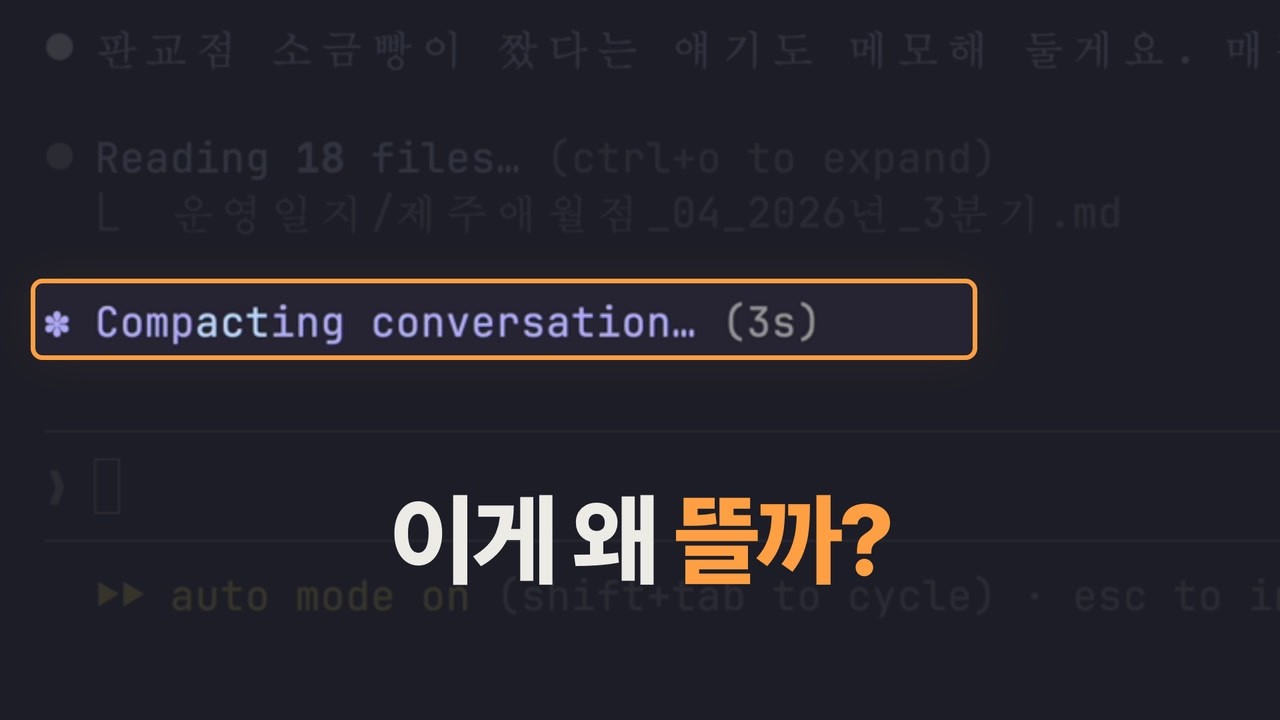
그래도 길게 일을 시키면 결국 가득 찹니다. 대화만 들어가는 것이 아니라 도구 설명, 올린 파일, AI가 찾아 읽은 자료까지 전부 이 안에 들어가기 때문입니다. 가득 차면 컴팩션 같은 방법으로 공간을 비웁니다.
상한을 그냥 늘리면 안 될까
늘릴 수는 있습니다. 하지만 세 가지 문제가 있습니다.
1. 비용
매번 처음부터 다시 넣으니, 주고받은 횟수가 늘수록 읽는 양이 빠르게 불어납니다. 10번 주고받으면 실제로는 1 + 2 + … + 10 = 55번 분량을 읽은 셈이고, 100번이면 5,050번 분량입니다.
2. 속도
AI는 답을 쓸 때 토큰 하나하나를 나머지 모든 토큰과 짝지어 살펴봅니다. 토큰이 4개면 4 × 4 = 16번, 8개면 8 × 8 = 64번입니다. 길이가 두 배가 되면 계산은 네 배가 됩니다.
3. 정확도
넣을 수 있다고 해서 잘 읽는 것은 아닙니다. 한 연구(Lost in the Middle)가 문서 20개 속에 정답이 든 문서 하나를 숨기고 위치를 바꿔 가며 정답률을 쟀습니다.
| 정답 문서 위치 | 1번째 | 5번째 | 10번째 | 15번째 | 20번째 |
|---|---|---|---|---|---|
| 정답률 (GPT-3.5-Turbo) | 75.8% | 57.2% | 53.8% | 55.4% | 63.2% |
맨 앞이나 맨 뒤에 있을 때보다 중간에 있을 때 훨씬 잘 놓쳤습니다. 정답이 중간에 있을 때(53.8%)는 문서를 아예 주지 않고 풀게 했을 때(56.1%)보다도 낮았습니다.
정리
컨텍스트 윈도우는 LLM이 한 번에 볼 수 있는 글의 양입니다. 대화가 길어질수록 이 공간을 채우고, 크게 늘리면 비용 · 속도 · 정확도 문제가 생깁니다. 그래서 오래 대화하는 도구들은 창이 가득 차기 전에 오래된 대화를 요약해 넣는 컴팩션을 씁니다.
출처와 실험 환경
- Liu et al. (2023), "Lost in the Middle: How Language Models Use Long Contexts" 표 6 (GPT-3.5-Turbo, 문서 20개 중 정답 1개) arxiv.org/abs/2307.03172
- 영상 속 화면: Claude Code v2.1.293 · Haiku 5.5, 2026년 10월 8일 녹화. 압축이 빨리 일어나도록 압축 기준을 10만 토큰으로 낮춰 촬영했고, 화면 속 회사와 자료는 촬영용으로 지어낸 것입니다